ระบบขึ้นใช้งานจริงแล้ว ฝ่ายจัดซื้อได้รับร่างสัญญา MA (Maintenance Agreement) แนบ SLA หนึ่งหน้า เขียนว่า "ผู้รับจ้างดูแลระบบตลอดอายุสัญญา ตอบสนองภายใน 1 ชั่วโมง" หลายเดือนต่อมา ระบบล่มตอนตีสองของวันหยุดยาว ผู้ให้บริการตอบรับทันเวลา แต่ระบบกลับมาใช้ได้ตอนสาย และเมื่อขอให้แก้รายงานที่ผิด กลับได้รับใบเสนอราคาใหม่เพราะ "เป็น Change Request"
ทั้งสองฝ่ายอาจไม่ได้ผิดสัญญาเลย เพราะสัญญาไม่ได้เขียนให้ชัดตั้งแต่แรก บทความนี้เขียนสำหรับ IT Manager ผู้บริหาร และฝ่ายจัดซื้อที่ต้องตรวจสัญญา MA และ SLA ก่อนเซ็น โดยเน้นข้อสัญญาที่ต้องถาม ไม่ใช่การเลือกรูปแบบการดูแลหรือระดับราคา ตัวอย่างในบทความเป็นกรณีสมมติ ไม่ใช่ผลลัพธ์จากลูกค้าและไม่ใช่คำแนะนำทางกฎหมาย
สัญญา MA ครอบคลุมอะไร และไม่ครอบคลุมอะไร?
โดยทั่วไปควรกำหนดให้ค่า MA ครอบคลุมการแก้ข้อบกพร่องของระบบที่ส่งมอบแล้ว ส่วนการเพิ่มความสามารถใหม่หรือปรับระบบตามความต้องการที่เปลี่ยนไปควรแยกเป็นงานที่เสนอราคาต่างหาก ปัญหาคือแต่ละฝ่ายนิยามคำว่า "บั๊ก" ต่างกัน จึงต้องเขียนประเภทงานและเกณฑ์แบ่งไว้ในสัญญา
SWEBOK V3 บทที่ 5 (IEEE Computer Society) แบ่งงานบำรุงรักษาหลังส่งมอบเป็นสี่ประเภทตามมาตรฐาน IEEE 14764 มาตรฐานนี้จัด corrective กับ preventive เป็น "corrections" และ adaptive กับ perfective เป็น "maintenance enhancements" การใช้คำเหล่านี้ในสัญญาช่วยให้ทั้งสองฝ่ายคุยภาษาเดียวกัน
หมายเหตุ: SWEBOK V3 เป็นฉบับปี 2014 ปัจจุบัน IEEE Computer Society เผยแพร่ SWEBOK V4 แล้ว และมาตรฐาน 14764 ฉบับปัจจุบันคือ ISO/IEC/IEEE 14764:2022 บทความนี้อ้างนิยามจาก V3 ที่เปิดอ่านได้ฟรี
| ประเภทงาน | ความหมาย (อิง SWEBOK V3) และตัวอย่าง | สิ่งที่ควรเขียนในสัญญา |
|---|---|---|
| Corrective | แก้ไขเชิงรับหลังส่งมอบ เพื่อแก้ปัญหาที่พบ ตัวอย่าง: รายงานคำนวณผิดจากที่ตกลงไว้ | ควรรวมในค่า MA ระบุว่าวัดเทียบกับข้อกำหนดหรือผลตรวจรับฉบับใด |
| Adaptive | ปรับให้ยังใช้ได้ในสภาพแวดล้อมที่เปลี่ยนไป ตัวอย่าง: อัปเกรดระบบปฏิบัติการ | รวมใน MA ถึงขนาดใด เกินนั้นเป็น Change Request |
| Perfective | เพิ่มความสามารถให้ผู้ใช้ ปรับเอกสาร หรือเขียนโค้ดใหม่ให้เร็วหรือดูแลง่ายขึ้น | มักกำหนดเป็น Change Request หรือใช้โควตาชั่วโมงที่ตกลง |
| Preventive | แก้ข้อบกพร่องแฝงก่อนกลายเป็นปัญหาระหว่างใช้งาน | ใครเสนอ ใครอนุมัติ และนับในค่า MA หรือไม่ |
SWEBOK V3 ยังนิยาม emergency maintenance เป็นส่วนหนึ่งของ corrective คือการแก้ไขนอกแผนเพื่อให้ระบบใช้งานได้ชั่วคราวระหว่างรอการแก้ไขถาวร แนวคิดนี้สำคัญเมื่อนิยามเวลาในหัวข้อถัดไป
แผนภาพแบ่งสัญญาเป็นสามโซน: รวมในค่า MA (corrective, emergency fix และ preventive ที่อนุมัติ) Change Request (perfective และ adaptive ที่เกินเกณฑ์) และ นอกขอบเขต (งาน operation ที่ไม่ได้ระบุ บริการภายนอกที่มี SLA ของตัวเอง และปัญหาจากการแก้ไขโดยบุคคลอื่น)
SWEBOK V3 ระบุด้วยว่าทีมบำรุงรักษาซอฟต์แวร์ (maintainer) อาจปฏิเสธคำขอที่เกินขนาด ปริมาณงาน (effort) หรือความซับซ้อนระดับหนึ่ง แล้วส่งต่อเป็นงานพัฒนา สัญญาจึงควรมี เกณฑ์ขนาดงาน ที่ตกลงร่วมกัน เช่น งานที่ประเมินแล้วเกินจำนวนชั่วโมงที่กำหนดต่อคำขอ หรือกระทบโครงสร้างฐานข้อมูล ให้เข้ากระบวนการ Change Request ตัวเลขที่เหมาะขึ้นกับขนาดระบบ
ทำไมคำว่า "ดูแลระบบ" ในสัญญาอาจไม่รวม backup และ server?
เพราะคำว่า software maintenance ในมาตรฐาน ISO/IEC/IEEE 14764 ไม่รวมงาน operation เช่น backup และ recovery ถ้าสัญญาไม่เขียนแยก แต่ละฝ่ายจึงอาจตีความต่างกัน หากต้องการให้ผู้ให้บริการทำ backup, restore หรือดูแล server ต้องเขียนเป็นรายการงานแยกในสัญญา
ขอบเขตของ ISO/IEC/IEEE 14764:2022 (สรุปขอบเขตจากแค็ตตาล็อกมาตรฐาน EVS) ระบุว่ามาตรฐานไม่ครอบคลุมการปฏิบัติการ (operation) ของซอฟต์แวร์ เช่น backup, recovery และ system administration ซึ่งปกติเป็นหน้าที่ของผู้ดูแลการปฏิบัติการระบบ
สัญญา MA ด้านแอปพลิเคชันจึงควรมีภาคผนวกที่ระบุว่า ใครดูแล server, database, network และบัญชี cloud ใครถือสิทธิ์ผู้ดูแลระบบและอนุมัติการเข้าถึง production และงาน monitoring, patch, backup อยู่ในสัญญานี้หรือในสัญญา managed operations อีกฉบับ
ถ้ายังเลือกไม่ได้ว่าจะให้ผู้ให้บริการหรือทีมภายในดูแลส่วน operation ดูการเปรียบเทียบรูปแบบและต้นทุนได้ใน Managed Services กับ In-house IT
ระดับความรุนแรง (Severity หรือ Priority) ควรนิยามอย่างไร?
นิยามจากผลกระทบต่อธุรกิจและความเร่งด่วน ไม่ใช่จากความรู้สึกของผู้แจ้ง แต่ละระดับควรมีตัวอย่างจากระบบจริง และระบุว่าใครมีสิทธิ์จัดหรือปรับระดับ ในบทความนี้ คำว่าระดับความรุนแรง (severity/priority) หมายถึงระดับ P1–P5 แบบในตารางด้านล่าง
แนวทางจัดการ incident ของ UK Cabinet Office กำหนด priority จากตาราง impact × urgency ด้าน impact ดูจำนวนพนักงานที่ได้รับผลกระทบ งานธุรกิจที่หยุดชะงัก ระดับตำแหน่งของผู้ได้รับผลกระทบ และข้อมูลอ่อนไหวที่มีความเสี่ยง ด้าน urgency ดูความเร่งด่วนด้านเวลา การมีทางแก้ชั่วคราวที่ง่าย และอัตราที่ระบบแย่ลง
ตารางด้านล่างคือ เป้าหมายภายในขององค์กรเดียว สำหรับบริการภายในในเวลาทำการ (In-Hour Support) ยกมาให้เห็นรูปแบบการเขียน ไม่ใช่มาตรฐานอุตสาหกรรม ไม่ใช่ค่าตลาดไทย และไม่ใช่คำแนะนำว่าควรตั้งเท่านี้
| ระดับ | นิยามในแนวทางของ Cabinet Office | Response (เป้าหมาย Cabinet Office) | Resolution (เป้าหมาย Cabinet Office) |
|---|---|---|---|
| P1 Critical | บริการธุรกิจหลักหยุด เช่น network, email หรือ SSO ของพนักงานทั้งหมดใช้ไม่ได้ | ภายใน 20 นาที | ภายใน 1 ชั่วโมง |
| P2 Major | บริการสำคัญเสื่อมประสิทธิภาพอย่างมาก | ภายใน 1 ชั่วโมง | 4–8 ชั่วโมง |
| P3 Significant | บริการหลักมีปัญหาเป็นช่วง ๆ | ภายใน 2 ชั่วโมง | 1–2 วันทำการ |
| P4 Minor | ปัญหาของผู้ใช้รายเดียวที่มีทางแก้ชั่วคราว | ภายใน 4 ชั่วโมง | 3–5 วันทำการ |
| P5 Monitor | ไม่ต้องทำอะไรเพิ่มนอกจากเฝ้าดู | ภายใน 1 วันทำการ | บันทึกเข้า backlog |
สิ่งที่ควรนำมาใช้คือโครงสร้าง: แต่ละระดับมีนิยาม ตัวอย่าง และเป้าหมาย response กับ resolution แยกกัน ในสัญญาควรเพิ่มตัวอย่างของตัวเอง เช่น "ลูกค้าของผู้ว่าจ้างชำระเงินไม่ได้ทั้งหมด" หรือ "รายงานประจำวันออกช้าแต่ข้อมูลถูกต้อง" และระบุผู้ตัดสินเมื่อสองฝ่ายเห็นไม่ตรงกัน
Response, Restoration และ Resolution ต่างกันอย่างไร?
Response คือผู้ให้บริการรับเรื่องและเริ่มดำเนินการ Restoration คือบริการกลับมาใช้ได้ อาจด้วยทางแก้ชั่วคราว ส่วน Resolution คือแก้สาเหตุอย่างถาวร SLA ที่เขียนแค่ "ตอบสนองภายใน 1 ชั่วโมง" รับประกันเพียงข้อแรก
- Response: ระบุว่าข้อความตอบกลับอัตโนมัติไม่นับ ต้องเป็นผู้รับผิดชอบที่ยืนยันรับเรื่องและเริ่มตรวจสอบ
- Restoration: ตรงกับ emergency maintenance ของ SWEBOK V3 เช่น สลับไปเครื่องสำรอง หรือปิดฟีเจอร์ที่มีปัญหา
- Resolution: การแก้ไขถาวรที่ทดสอบและขึ้น production แล้ว พร้อมระบุว่าใครยืนยันการปิดงาน
แนวทางของ Cabinet Office ถือว่า incident ได้รับการแก้ไขเมื่อ incident lead เห็นว่าบริการกลับมาแล้ว ซึ่งใกล้กับ restoration มากกว่าการแก้ถาวร คำว่า "resolved" จึงหมายถึงเหตุการณ์ต่างกันได้ในแต่ละองค์กร สัญญาต้องระบุว่าเหตุการณ์ใดหยุดนาฬิกาของแต่ละเป้าหมาย
นาฬิกา SLA เริ่ม พัก และหยุดเมื่อไร?
นาฬิกาเริ่มเมื่อเกิดเหตุการณ์ที่สัญญากำหนด เช่น ticket ถูกสร้าง พักเมื่อรอข้อมูลหรือการอนุมัติจากผู้ว่าจ้าง และหยุดเมื่อถึงเหตุการณ์ที่นิยามไว้ ทั้งหมดนับตามปฏิทินเวลาทำการที่ระบุในสัญญา
เอกสาร Jira Service Management แสดงกลไกนี้ชัด: SLA มีเงื่อนไข start, pause และ stop โดยยกตัวอย่างการพักเมื่อรอลูกค้าตอบกลับ ส่วน ปฏิทิน SLA กำหนด timezone วันทำงาน ช่วงเวลาทำงาน และวันหยุด ปฏิทินใหม่ตั้งค่าเริ่มต้นไว้ที่ 09:00–17:00 หากสัญญาไม่ระบุ ค่าเริ่มต้นของเครื่องมืออาจกลายเป็นข้อตกลงโดยไม่มีใครตั้งใจ
ข้อแนะนำของเรา:
- ระบุ timezone Asia/Bangkok และปฏิทินวันหยุดที่ใช้ เช่น วันหยุดราชการไทย หรือวันหยุดของบริษัทผู้ว่าจ้าง
- ระบุว่าระดับใดนับแบบ 24×7 และระดับใดนับเฉพาะเวลาทำการ
- เขียนเงื่อนไขพักนาฬิกาเป็นรายการปิด และกำหนดให้บันทึกการพักใน ticket พร้อมเวลา
- ระบุช่องทางแจ้งที่เริ่มนาฬิกาได้ และการแจ้งผ่านแชตส่วนตัวนับหรือไม่
ทำไม SLA ผ่าน response time แต่ระบบยังล่มอยู่ได้?
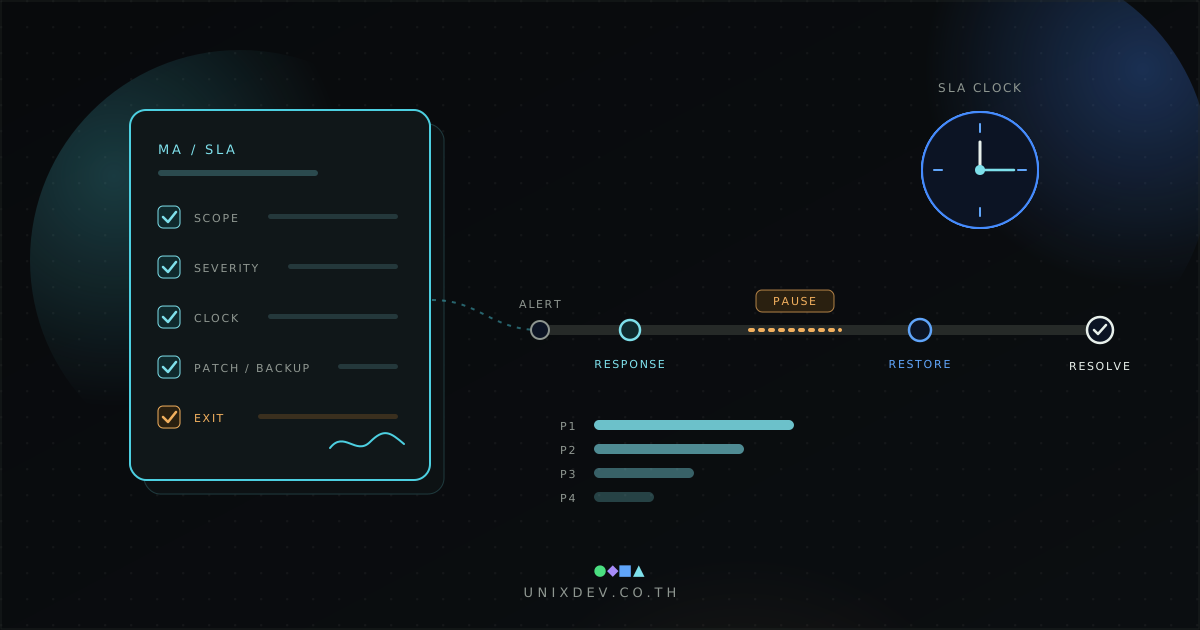
เพราะ response พิสูจน์เพียงว่ามีคนรับเรื่องแล้ว ส่วน restoration และ resolution เป็นนาฬิกาแยกที่อาจตามมาอีกหลายชั่วโมงหรือหลายวัน ไทม์ไลน์ด้านล่างแสดงให้เห็นว่าเหตุการณ์เดียวอ่านตัวเลขได้ต่างกันมากแค่ไหน
ตัวเลขต่อไปนี้เป็นตัวเลขสมมติเพื่ออธิบายวิธีอ่านเวลา ไม่ใช่ผลลัพธ์จากลูกค้าและไม่ใช่ค่าที่แนะนำ สมมติระบบสั่งซื้อออนไลน์ล่มเวลา 02:10 ของเช้าวันอาทิตย์ สัญญานับ P1 แบบ 24×7 และให้การรออนุมัติจากผู้ว่าจ้างเป็นเงื่อนไขพักนาฬิกา
- 02:10 monitoring แจ้งเตือนและสร้าง ticket นาฬิกาเริ่ม
- 02:25 วิศวกรเวรยืนยันรับเรื่อง: response 15 นาที
- 02:50–03:20 รอผู้ว่าจ้างอนุมัติให้สลับไปฐานข้อมูลสำรอง นาฬิกาพัก 30 นาที
- 03:40 ระบบกลับมาใช้ได้ด้วยทางแก้ชั่วคราว: restoration 90 นาทีตามเวลาจริง หรือ 60 นาทีตามนาฬิกา SLA
- วันทำการถัดไป 14:00 นำการแก้ไขถาวรขึ้น production หลังผู้ว่าจ้างทดสอบผ่าน: resolution แล้วส่งรายงานทบทวนหลังเหตุการณ์ตามกรอบเวลาในสัญญา
ถ้าสัญญาเขียนแค่ response time ผู้ให้บริการผ่าน SLA ตั้งแต่ 02:25 ถ้าเขียน restoration โดยไม่มีเงื่อนไขพัก ตัวเลขจะเป็น 90 นาที ไม่ใช่ 60 นาที และถ้าไม่เขียนเรื่อง resolution การแก้ถาวรอาจเลื่อนออกไปเรื่อย ๆ ตัวเลขทั้งสามจึงควรอยู่ทั้งในสัญญาและในรายงานรายเดือน
Monitoring และรายงานรายเดือนควรมีอะไร?
รายงานควรแสดงผล SLA ราย ticket ไม่ใช่เพียงเปอร์เซ็นต์รวม พร้อมงานค้าง งานป้องกัน และความเสี่ยงที่พบ เพื่อให้ผู้ว่าจ้างตรวจสอบเองได้
- ticket แยกตามระดับ พร้อมเวลา response, restoration, resolution และช่วงพักนาฬิกาพร้อมเหตุผล
- สิ่งที่ monitoring เฝ้าดู ใครรับการแจ้งเตือน และผู้ว่าจ้างดู dashboard ได้หรือไม่
- สถานะ patch, ผลทดสอบ restore, dependency ที่ใกล้หมดอายุ และ Change Request ที่เปิดอยู่
แนวทางของ Cabinet Office กำหนดให้ incident ระดับ P1 และ P2 ทุกครั้งต้องมี post-incident review เพื่อจัดทำรายงานและติดตามงานป้องกัน สัญญา MA ควรระบุว่าระดับใดต้องมีรายงานหลังเหตุการณ์และส่งภายในกี่วัน รวมทั้งระหว่างเหตุการณ์ต้องแจ้งความคืบหน้าบ่อยแค่ไหนในแต่ละระดับ
ใครรับผิดชอบ patch และ security update?
ต้องแยกให้ชัดว่าใครดูแล patch ของระบบปฏิบัติการ middleware ไลบรารี และโค้ดแอปพลิเคชัน รวมถึงใครอนุมัติ maintenance window หากสัญญาเงียบ แต่ละฝ่ายมักคิดว่าเป็นหน้าที่ของอีกฝ่าย
NIST SP 800-40 Rev. 4 (เมษายน 2022) นิยาม enterprise patch management ว่าเป็นกระบวนการระบุ จัดลำดับความสำคัญ จัดหา ติดตั้ง และตรวจยืนยันการติดตั้ง patch, update และ upgrade เอกสารนี้มองการ patch เป็นส่วนสำคัญของ preventive maintenance และเป็น "ต้นทุนของการทำธุรกิจ" ที่ช่วยป้องกันการถูกโจมตี ข้อมูลรั่ว และการหยุดชะงัก ห้าขั้นนี้ใช้เป็นหัวข้อในสัญญาได้โดยตรง:
| ขั้นตอน | คำถามที่สัญญาต้องตอบ |
|---|---|
| ระบุ | ใครติดตามประกาศช่องโหว่ของ OS, database, framework และไลบรารี |
| จัดลำดับ | ใช้เกณฑ์ใดตัดสินว่า patch ใดเร่งด่วน และต้องติดตั้งภายในกี่วัน |
| จัดหา | ใครดูแล subscription หรือ license ที่จำเป็นต่อการรับ patch |
| ติดตั้ง | ทดสอบบน staging ก่อนหรือไม่ ใช้ maintenance window ใด ใครอนุมัติ |
| ตรวจยืนยัน | หลักฐานอยู่ในรายงานใด และ rollback เมื่อ patch ทำให้ระบบเสียรวมในค่า MA หรือไม่ |
Backup และการทดสอบ restore ต้องเขียนอะไรในสัญญา?
ระบุว่าใครทำ backup อะไร เก็บที่ไหน และที่สำคัญกว่าคือใครทดสอบ restore บ่อยแค่ไหนและส่งหลักฐานอย่างไร backup ที่ไม่เคยทดสอบ restore ยังไม่ใช่หลักประกันว่าจะกู้ข้อมูลได้
มาตรการ CP-9(1) ใน NIST SP 800-53 Rev. 5 กำหนดให้ทดสอบข้อมูล backup ตามความถี่ที่องค์กรกำหนด เพื่อยืนยันความน่าเชื่อถือของสื่อและความถูกต้องของข้อมูล NIST ไม่ได้ให้ตัวเลขความถี่ องค์กรต้องเลือกเองตามความสำคัญของระบบแล้วเขียนลงสัญญา
นอกจากความถี่ทดสอบ สัญญาควรระบุ:
- ขอบเขต backup เช่น database, ไฟล์ที่ผู้ใช้อัปโหลด และ configuration
- ระยะเวลาเก็บ และสำเนาที่แยกจากระบบหลัก
- หลักฐานการทดสอบ restore ที่ต้องส่ง
- ผู้ที่ restore เมื่อเกิดเหตุจริง
Third-party dependency หมดอายุ ใครจ่ายค่าอัปเกรด?
ขึ้นกับว่าสัญญาจัดการอัปเกรดเมื่อ dependency หมดการสนับสนุนเป็น adaptive maintenance ที่รวมใน MA หรือเป็น Change Request ที่ผู้ว่าจ้างจ่ายแยก หากสัญญาไม่ระบุ เรื่องนี้มักกลายเป็นข้อโต้แย้งเมื่อถึงวัน end of life เพราะระบบทุกระบบพึ่ง runtime, framework, ไลบรารี และบริการ cloud ที่มีวงจรชีวิตของตัวเอง
ตัวอย่างที่เห็นภาพคือ นโยบายเวอร์ชันของ PHP: แต่ละ branch ได้รับการสนับสนุนเต็ม 2 ปี แล้วแก้เฉพาะปัญหาความปลอดภัยร้ายแรงอีก 2 ปี ก่อนถึง end of life ซึ่ง php.net เตือนว่าอาจมีช่องโหว่ที่ไม่ได้รับการแก้ไข ณ วันที่เขียน PHP 8.2 ได้รับ security support ถึง 31 ธันวาคม 2026 ระบบที่ยังใช้ 8.2 จึงต้องวางแผนอัปเกรดภายในรอบสัญญานี้ หากการอัปเกรดใหญ่จนเป็นการปรับโครงสร้างระบบ ดูทางเลือกใน การปรับปรุงระบบเก่า
อีกเรื่องที่มักเข้าใจผิดคือ SLA ของผู้ให้บริการ cloud ครอบคลุมเฉพาะบริการของผู้ให้บริการ cloud เอง เช่น Amazon Compute SLA ยกเว้นความไม่พร้อมใช้งานที่เกิดจากการกระทำหรือการละเว้นของลูกค้า และจากอุปกรณ์หรือซอฟต์แวร์ของลูกค้า แอปพลิเคชันขององค์กรจึงต้องมี SLA ของตัวเอง
Service credit ชดเชยความเสียหายได้แค่ไหน?
ตัวอย่างจาก Amazon Compute SLA แสดงว่า service credit อาจเป็นเพียงส่วนลดค่าบริการที่มีเพดาน ต้องยื่นขอเองภายในกำหนด และอาจถูกระบุว่าเป็นการเยียวยาเพียงอย่างเดียว จึงไม่ควรถือว่า credit เป็นค่าชดเชยความเสียหายทางธุรกิจ
Amazon Compute SLA (ปรับปรุงล่าสุด 25 พฤษภาคม 2022) แสดงรายละเอียดเหล่านี้ครบ: credit คิดเป็น 10%, 30% หรือ 100% ของค่าบริการรายเดือนของบริการที่ได้รับผลกระทบ มีเพดานไม่เกิน 100% ลูกค้าต้องยื่นขอภายในสิ้นรอบบิลที่สองหลังเกิดเหตุ SLA นี้ระบุว่าเป็น "sole and exclusive remedies" ของลูกค้า และมีข้อยกเว้น เช่น ปัจจัยนอกการควบคุมของ AWS รวมถึงเหตุสุดวิสัย
ให้ถามคำถามเดียวกันกับสัญญา MA: ฐานคำนวณ เพดาน วิธีและกำหนดยื่น ข้อยกเว้น และการจำกัดสิทธิ์เรียกร้องอื่น สำหรับระบบที่สร้างรายได้สูง credit ไม่กี่เปอร์เซ็นต์ของค่า MA ไม่สะท้อนความเสียหายจริง ควรลงทุนให้ระบบทนทานแทนการพึ่ง credit และปรึกษาที่ปรึกษากฎหมายเรื่องเพดานความรับผิด
Change Request ควรมีขั้นตอนอย่างไร?
ทุกคำขอควรผ่านขั้นตอนเดียวกัน คือบันทึกคำขอ ประเมินผลกระทบ เสนอราคาและเวลา รออนุมัติเป็นลายลักษณ์อักษร แล้วจึงลงมือ ขั้นตอนนี้ปกป้องทั้งงบของผู้ว่าจ้างและเวลาของผู้ให้บริการ
SWEBOK V3 เรียกคำขอเหล่านี้ว่า modification request (MR) หรือ problem report (PR) คำขอเดียวจึงอาจเริ่มจากการแจ้งปัญหาแล้วกลายเป็นงานเปลี่ยนแปลงหลังวิเคราะห์ สัญญาควรระบุ:
- ผู้จัดประเภทคำขอ และผู้ตัดสินเมื่อสองฝ่ายเห็นต่าง
- ระยะเวลาส่งผลประเมินและใบเสนอราคา
- อัตราค่าบริการ และโควตาชั่วโมงที่รวมใน MA (ถ้ามี)
- ผู้มีอำนาจอนุมัติฝั่งผู้ว่าจ้าง
- การอัปเดตเอกสารระบบหลังส่งมอบงานแต่ละครั้ง
ดูวิธีเตรียมขอบเขตงานแบบเดียวกันได้ใน การเตรียมข้อมูลก่อนขอใบเสนอราคาพัฒนาซอฟต์แวร์
ต่ออายุ ยกเลิก และข้อมูลส่วนบุคคล ต้องเขียนอะไรในสัญญา?
สัญญาต้องระบุเงื่อนไขต่ออายุและการปรับราคา สิทธิ์ยกเลิก สิ่งที่ต้องส่งมอบเมื่อสัญญาจบ และการลบหรือคืนข้อมูลส่วนบุคคล ส่วนนี้มักถูกอ่านข้ามจนถึงวันที่ต้องเปลี่ยนผู้ให้บริการ
อย่างน้อยให้ตรวจว่าต่ออายุอัตโนมัติหรือไม่และต้องแจ้งล่วงหน้ากี่วัน สูตรปรับราคา สิทธิ์ยกเลิกเมื่อไม่ผ่าน SLA ซ้ำ ๆ พร้อมนิยามคำว่า "ซ้ำ" และช่วงส่งมอบงานเมื่อจบสัญญา รายการส่งมอบโดยละเอียดดูได้ใน เช็กลิสต์รับมอบงานจากผู้พัฒนาซอฟต์แวร์
ผู้ให้บริการ MA ที่เข้าถึง production มักต้องประมวลผลข้อมูลส่วนบุคคลแทนองค์กร จึงควรมีข้อตกลงการประมวลผลข้อมูล (DPA) แนบสัญญา ตัวอย่างอ้างอิงคือ ร่างข้อตกลงการประมวลผลข้อมูลที่สำนักงานคณะกรรมการดิจิทัลเพื่อเศรษฐกิจและสังคมแห่งชาติ (สดช.) ใช้กับผู้ให้บริการของตน ซึ่งระบุว่าจัดทำตาม พ.ร.บ.คุ้มครองข้อมูลส่วนบุคคล พ.ศ. 2562 มาตรา 40 วรรคสาม หลักสำคัญในร่างข้อตกลงนี้:
- ผู้ให้บริการเป็นผู้ประมวลผลข้อมูล ประมวลผลตามคำสั่งเป็นลายลักษณ์อักษรของผู้ใช้บริการเท่านั้น และต้องมีมาตรการรักษาความปลอดภัยที่เหมาะสมทั้งเชิงองค์กรและเชิงเทคนิค
- ห้ามใช้ผู้ประมวลผลช่วงโดยไม่ได้รับอนุญาตเป็นลายลักษณ์อักษร และผู้ประมวลผลยังต้องรับผิดชอบต่อผู้ประมวลผลช่วง
- แจ้งเหตุละเมิดข้อมูลแก่ผู้ใช้บริการโดยไม่ชักช้า ร่างข้อตกลงนี้ใช้ตัวเลข 24 ชั่วโมงนับจากทราบเหตุ และต้องให้ความร่วมมือในการตรวจสอบ
- เมื่อสัญญาหลักสิ้นสุด ต้องลบ ทำลาย หรือส่งคืนข้อมูลภายในระยะเวลาที่กำหนด ร่างข้อตกลงนี้ยกตัวอย่าง 7 วัน
ตัวเลข 24 ชั่วโมงและ 7 วันเป็น ตัวเลขในร่างข้อตกลงของ สดช. ไม่ใช่ข้อกำหนดของกฎหมาย ควรกำหนดค่าที่เหมาะสมร่วมกับเจ้าหน้าที่คุ้มครองข้อมูลส่วนบุคคลและที่ปรึกษากฎหมาย
ก่อนเซ็นสัญญา MA และ SLA ต้องตรวจข้อใดบ้าง?
ตรวจหกกลุ่มหลัก: ขอบเขตงานและเกณฑ์ Change Request, นิยามระดับความรุนแรง, เป้าหมายเวลาและนาฬิกา SLA, ความรับผิดชอบเรื่อง patch, backup และ dependency, เงื่อนไข service credit และการต่ออายุ การส่งมอบเมื่อจบสัญญา และ DPA ตารางนี้ใช้ทบทวนร่างสัญญาร่วมกันระหว่าง IT ฝ่ายจัดซื้อ และฝ่ายกฎหมาย คอลัมน์สัญญาณเตือนคือข้อความที่ควรขอแก้ก่อนเซ็น
| ข้อสัญญา | คำถามที่ต้องถาม | สัญญาณเตือน |
|---|---|---|
| ขอบเขตงาน | corrective, adaptive, perfective, preventive ประเภทใดรวมในค่า MA | เขียนเพียง "ดูแลระบบให้ใช้งานได้ตามปกติ" |
| เกณฑ์ Change Request | งานขนาดเท่าใดต้องเสนอราคาแยก ใครตัดสิน | ผู้ให้บริการตัดสินฝ่ายเดียวโดยไม่มีเกณฑ์ |
| งาน operation | backup, restore, system admin อยู่ในสัญญานี้หรือฉบับอื่น | ไม่มีคำว่า backup หรือ restore เลย |
| ระดับความรุนแรง | แต่ละระดับมีนิยามและตัวอย่างจากระบบจริงหรือไม่ | ผู้ให้บริการจัดระดับฝ่ายเดียว |
| เป้าหมายเวลา | มี response, restoration และ resolution แยกกันหรือไม่ | มีแค่ response time |
| นาฬิกา SLA | timezone, เวลาทำการ, วันหยุด และเงื่อนไขพักคืออะไร | เงื่อนไขพักเขียนกว้าง เช่น "กรณีอื่นตามที่ผู้ให้บริการเห็นสมควร" |
| รายงาน | มีรายละเอียดราย ticket และรายงานหลังเหตุการณ์หรือไม่ | มีแค่เปอร์เซ็นต์รวม |
| Patch | ใครดูแล OS, middleware และไลบรารี ใช้ maintenance window ใด | ไม่ระบุว่าใครติดตามช่องโหว่ของไลบรารี |
| Backup และ restore | ทดสอบ restore บ่อยแค่ไหน ส่งหลักฐานอะไร | มีแค่ความถี่ backup ไม่มีการทดสอบ restore |
| Dependency และ EOL | เมื่อ runtime หรือ framework หมดอายุ ใครจ่ายค่าอัปเกรด | ไม่มีรายชื่อ dependency และวันหมดการสนับสนุน |
| Service credit | ฐานคำนวณ เพดาน วิธียื่น ข้อยกเว้น และเป็นการเยียวยาเพียงอย่างเดียวหรือไม่ | ระบุเป็นการเยียวยาเพียงอย่างเดียว และกำหนดเวลายื่นสั้นมาก |
| ต่ออายุและ exit | ต่ออายุและปรับราคาอย่างไร ส่งมอบอะไรเมื่อจบสัญญา | ไม่มีข้อส่งมอบ source code เอกสาร และสิทธิ์เข้าถึง |
| ข้อมูลส่วนบุคคล | มี DPA หรือไม่ ใช้ผู้ประมวลผลช่วงได้หรือไม่ แจ้งเหตุละเมิดภายในเท่าไร | เข้าถึงข้อมูลลูกค้าใน production โดยไม่มี DPA |
ก่อนประชุมเจรจา ให้เตรียมรายการระบบและ dependency หลัก ผลกระทบทางธุรกิจเมื่อแต่ละส่วนหยุด ผู้อนุมัติฝั่งผู้ว่าจ้าง และงาน operation ที่ทีมภายในจะทำเอง เพื่อกำหนดระดับความรุนแรงและขอบเขตให้ตรงกับความเสี่ยงจริง แทนการรับเทมเพลตของผู้ให้บริการมาทั้งชุด
UNIXDEV ดูแลระบบหลังขึ้นใช้งานจริงผ่านบริการ DevOps, SRE และ Managed Operations ครอบคลุม monitoring, patch, backup และการรับมือ incident ตามขอบเขตที่ตกลงในสัญญา ส่วนการแก้ไขและปรับปรุงแอปพลิเคชันเดิม ดูบริการ Legacy Application Maintenance เราช่วยทบทวนนิยามระดับความรุนแรง ขอบเขตงาน และเงื่อนไขนาฬิกา SLA ให้ตรงกับระบบของคุณก่อนเริ่มสัญญา
แหล่งอ้างอิงและอ่านต่อ
- SWEBOK V3 (2014) — Chapter 5: Software Maintenance (IEEE Computer Society)
- IEEE Computer Society — SWEBOK Guide (ฉบับปัจจุบัน V4)
- ISO/IEC/IEEE 14764:2022 Software engineering — Maintenance (สรุปขอบเขตจากแค็ตตาล็อก EVS)
- UK Cabinet Office — Technical incident management guidance
- Atlassian — Set up SLA conditions และ Set up SLA calendars
- Amazon Compute Service Level Agreement
- NIST SP 800-40 Rev. 4 — Guide to Enterprise Patch Management Planning
- NIST SP 800-53 Rev. 5 — Security and Privacy Controls (CP-9(1) System Backup: Testing for Reliability and Integrity)
- PHP — Supported Versions
- สดช. — (ร่าง) ข้อตกลงการประมวลผลข้อมูล PDPA-DPA-6601
- บทความที่เกี่ยวข้อง: Managed Services กับ In-house IT
- บทความที่เกี่ยวข้อง: เช็กลิสต์รับมอบงานจากผู้พัฒนาซอฟต์แวร์
บทความโดย UNIXDEV Team · 23 ตุลาคม 2026 · เช็กลิสต์และไทม์ไลน์ตัวอย่างจัดทำเพื่อประกอบการตรวจสัญญา ตัวอย่างทั้งหมดเป็นกรณีสมมติ ไม่ใช่คำแนะนำทางกฎหมาย
คำถามที่พบบ่อย
ก่อนเซ็นสัญญา MA และ SLA ดูแลระบบ ต้องตรวจข้อใดบ้าง?
ตรวจว่างานแบบไหนรวมในค่าบริการรายเดือนและแบบไหนต้องเสนอราคาแยก ความรุนแรงแต่ละระดับนิยามอย่างไร นาฬิกา SLA เริ่ม พัก และหยุดเมื่อไร และใครรับผิดชอบ patch, backup และ dependency ภายนอก หากข้อใดตอบไม่ได้จากตัวสัญญา ให้แก้ก่อนเซ็น
สัญญา MA ดูแลระบบควรครอบคลุมงานอะไร และงานไหนต้องเสนอราคาแยก?
โดยทั่วไปควรกำหนดให้ค่า MA ครอบคลุมการแก้ข้อบกพร่องของระบบที่ส่งมอบแล้ว (corrective) emergency fix และ preventive ที่อนุมัติ ส่วนการเพิ่มฟีเจอร์ (perfective) และ adaptive ที่เกินเกณฑ์ขนาดงานควรเป็น Change Request ที่ต้องประเมินผลกระทบและเสนอราคาแยก ควรเขียนเกณฑ์แบ่งนี้ไว้ในสัญญาให้ชัด
Response time กับ Resolution time ใน SLA ต่างกันอย่างไร?
Response คือผู้ให้บริการรับเรื่องและเริ่มดำเนินการ Restoration คือบริการกลับมาใช้ได้ซึ่งอาจเป็นทางแก้ชั่วคราว ส่วน Resolution คือการแก้สาเหตุอย่างถาวร SLA ที่เขียนแค่ response time รับประกันเพียงการรับเรื่อง ไม่ได้รับประกันว่าระบบจะกลับมาใช้ได้เมื่อไร
นาฬิกา SLA ควรเริ่ม พัก และหยุดเมื่อไร?
นาฬิกาเริ่มเมื่อเกิดเหตุการณ์ที่สัญญากำหนด เช่น ticket ถูกสร้าง พักเมื่อรอข้อมูลหรือการอนุมัติจากผู้ว่าจ้าง และหยุดเมื่อถึงเหตุการณ์ที่นิยามไว้ สัญญาควรระบุ timezone ปฏิทินวันหยุด ระดับที่นับแบบ 24×7 และเขียนเงื่อนไขพักนาฬิกาเป็นรายการปิด
ถ้าสัญญาเขียนว่าดูแลระบบ จะรวม backup และ restore ด้วยหรือไม่?
ไม่เสมอไป คำว่า software maintenance ในมาตรฐาน ISO/IEC/IEEE 14764 ไม่รวมงาน operation เช่น backup และ recovery ถ้าสัญญาไม่เขียนแยก แต่ละฝ่ายจึงอาจตีความต่างกัน ควรเขียนงานเหล่านี้แยกในสัญญา พร้อมระบุความถี่ทดสอบ restore หลักฐานที่ส่ง และผู้ที่ restore เมื่อเกิดเหตุจริง
Service credit ใน SLA ชดเชยความเสียหายทางธุรกิจได้หรือไม่?
ไม่ควรถือว่าเป็นค่าชดเชยความเสียหายทางธุรกิจ ตัวอย่างจาก Amazon Compute SLA แสดงว่า service credit อาจเป็นเพียงส่วนลดค่าบริการที่มีเพดาน ต้องยื่นขอเองภายในกำหนด และอาจถูกระบุว่าเป็นการเยียวยาเพียงอย่างเดียว ควรตรวจฐานคำนวณ เพดาน วิธียื่น ข้อยกเว้น และการจำกัดสิทธิ์เรียกร้องอื่นก่อนเซ็น