สัญญาดูแลระบบกับผู้รับจ้างเดิมจะหมดในอีกไม่กี่สัปดาห์ หรือทีมที่เขียนระบบมาตั้งแต่แรกกำลังจะย้ายไปทำงานอื่น ระบบยังเปิดใช้งานทุกวัน แต่เมื่อถามว่ารหัสผ่านบัญชี Cloud อยู่กับใคร โดเมนจดในชื่อบริษัทไหม หรือ backup ล่าสุดกู้คืนได้จริงหรือเปล่า คำตอบมักเป็น "น่าจะอยู่ที่ทีมเดิม"
บทความนี้เป็นคู่มือฝั่งผู้ว่าจ้างสำหรับ IT Manager ผู้บริหาร และฝ่ายจัดซื้อ เมื่อต้องเปลี่ยนผู้รับจ้างหรือทีมที่ดูแลระบบที่ใช้งานอยู่ ไม่ว่าจะย้ายไปผู้รับจ้างรายใหม่หรือดึงกลับมาดูแลเอง ตั้งแต่รายการรับมอบ ข้อสัญญา การพิสูจน์ว่ารับมอบครบ จนถึงการถอนสิทธิ์ทีมเดิม
ทำไมการเปลี่ยนผู้รับจ้างดูแลระบบมักสะดุด?
สาเหตุหลักคือ "การควบคุม" ระบบกระจายอยู่กับคนและบัญชีของทีมเดิม มากกว่าที่องค์กรรู้ตัว เมื่อทีมเดิมออกไป สิ่งที่หายไปจึงไม่ใช่แค่ความรู้ แต่เป็นสิทธิ์เข้าถึงโค้ด เซิร์ฟเวอร์ โดเมน และข้อมูลด้วย
รูปแบบที่พบบ่อย:
- ได้โค้ดเป็นไฟล์ zip ไม่มีประวัติการแก้ไข ไม่รู้ว่าเวอร์ชันไหนตรงกับที่รันอยู่บน production
- บัญชี Cloud, โดเมน หรือบริการภายนอกผูกกับอีเมลส่วนตัวหรืออีเมลของผู้รับจ้าง ทำให้กู้รหัสผ่านหรือต่ออายุบริการไม่ได้
- มี backup แต่ไม่เคยทดสอบกู้คืน จึงไม่รู้ว่าครบหรือใช้ได้จริง
บทความนี้ต่างจาก แนวทางปรับปรุงระบบเก่า (Legacy Modernization) ตรงที่ยังไม่ได้ตัดสินใจว่าจะ rehost, refactor หรือ rebuild แต่เป็นขั้นก่อนหน้านั้น คือทำให้องค์กรควบคุมระบบที่รันอยู่ได้จริงก่อน แล้วจึงค่อยวางแผนปรับปรุง
ต้องรับมอบอะไรจากผู้รับจ้างเดิมบ้าง?
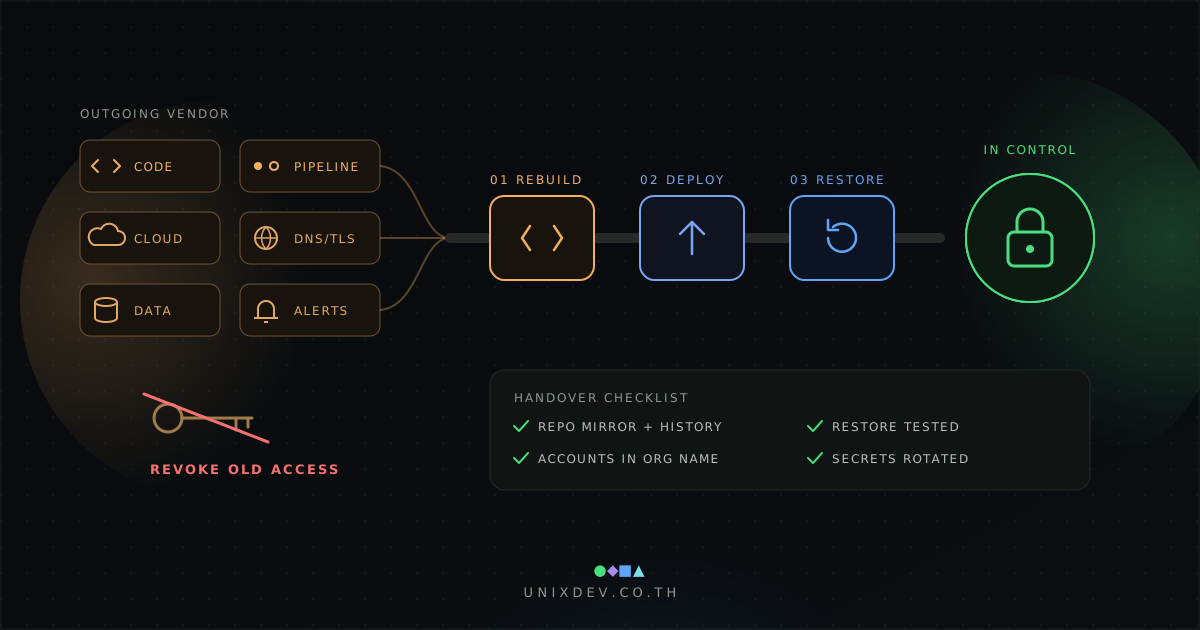
ต้องรับมอบทุกอย่างที่จำเป็นต่อการ build, deploy, เปิดให้บริการ และกู้คืนระบบ โดยไม่ต้องขอความช่วยเหลือจากทีมเดิม แบ่งได้เป็นห้ากลุ่ม คือ โค้ดและ pipeline, โครงสร้างพื้นฐานและบัญชี, ข้อมูลและ backup, การเฝ้าระวังและเอกสาร, และงานค้าง
1. ซอร์สโค้ดพร้อมประวัติทั้งหมด และ pipeline
ต้องได้ repository ทั้งชุดพร้อมประวัติ branch และ tag อยู่ในบัญชีขององค์กร พร้อม pipeline ค่า configuration ของแต่ละ environment และระบุได้ว่า commit ไหนรันอยู่บน production
คู่มือบริการของรัฐบาลสหราชอาณาจักร (GOV.UK Service Manual) ในบริบทการเปิดเผยซอร์สโค้ด แนะนำให้ระบุให้ชัดว่าใครเป็นเจ้าของโค้ดและผู้อื่นนำไปใช้ได้อย่างไร รวมถึงโค้ดที่ agency พัฒนาให้ และให้เก็บไว้ใน repository ที่หน่วยงานบริหารเอง ในกรณีเปลี่ยนผู้รับจ้าง เราแนะนำให้ย้าย repository มาไว้ในบัญชีขององค์กร แทนการพึ่ง repository ของผู้รับจ้าง
หลักฐานที่ดีกว่าไฟล์ zip คือ repository ทั้งชุด ตามเอกสารของ Git คำสั่ง git clone --mirror สร้าง mirror ที่เก็บ refs ทั้งหมด ไม่ใช่แค่ branch ปัจจุบัน ทำให้ได้ทั้งประวัติการแก้ไข branch และ tag ของแต่ละ release
นอกจากตัวโค้ด ต้องรับสิ่งต่อไปนี้ด้วย:
- pipeline สำหรับ build และ deploy
- ค่า configuration ของแต่ละ environment (dev, staging, production)
- รายการ dependency และเครื่องมือที่ต้องใช้
- ข้อมูลว่า commit ไหนคือสิ่งที่รันอยู่บน production ตอนนี้
2. โครงสร้างพื้นฐาน บัญชี โดเมน และบริการภายนอก
บัญชีระดับสูงสุดต้องผูกกับช่องทางที่องค์กรควบคุม คู่มือ AWS IAM เรื่อง root user แนะนำไว้ดังนี้:
- ใช้อีเมลที่ธุรกิจเป็นผู้จัดการและส่งต่อถึงกลุ่มคน เพื่อไม่ให้ติดขัดเมื่อบางคนลาหรือออกจากองค์กร
- เปิด MFA
- ไม่สร้าง access key ให้ root user
- ให้องค์กรควบคุมช่องทางกู้คืน คือกล่องอีเมลและหมายเลขโทรศัพท์ที่ลงทะเบียนไว้ โดยไม่ควรมีคนเดียวถือทั้งสองอย่าง
หลักการเดียวกันใช้ตรวจบัญชีของผู้ให้บริการรายอื่นได้
สำหรับโดเมน ตาม ICANN Transfer Policy ฉบับปรับปรุงปี 2024 ผู้ถือครองชื่อโดเมน (Registered Name Holder) เป็นผู้มีอำนาจอนุมัติหรือปฏิเสธการโอนโดเมนไปยัง registrar รายใหม่ และ registrar ต้องให้รหัส AuthInfo ที่ไม่ซ้ำกันของแต่ละโดเมนแก่ผู้ถือครอง ดังนั้นต้องตรวจว่าโดเมนจดในชื่อองค์กร ไม่ใช่ชื่อผู้รับจ้าง รวมถึงรับสิทธิ์จัดการ DNS และรู้ว่าใบรับรอง TLS ออกจากไหน ต่ออายุอย่างไร และแจ้งเตือนไปที่ใคร
บริการภายนอก เช่น ระบบส่งอีเมล SMS payment gateway หรือ license ให้ทำทะเบียนว่าบัญชีอยู่ในชื่อใคร ใครจ่าย และต่ออายุเมื่อไร
3. ฐานข้อมูล backup และผลทดสอบกู้คืน
หนังสือ Site Reliability Engineering ของ Google บท Data Integrity ชี้ว่าสิ่งที่องค์กรต้องการจริงไม่ใช่การมี backup แต่คือการกู้คืนข้อมูลได้ และระบุว่าการทดสอบที่เชื่อใจได้จริงคือการทดสอบแบบ end-to-end เพราะสิ่งที่ต้องใช้ระหว่างกู้คืนอาจเสียอยู่โดยไม่มีใครรู้จนกว่าจะลองกู้จริง
ดังนั้นสิ่งที่ต้องรับมอบไม่ใช่แค่ "มี backup" แต่คือ ตำแหน่งและสิทธิ์เข้าถึง backup ตารางการทำ backup ขั้นตอนกู้คืน และผลการกู้คืนที่ทีมใหม่ทำเองได้
4. Monitoring เอกสาร และงานค้าง
ตรวจว่า alert ส่งไปหาใคร ถ้ายังส่งไปที่ทีมเดิม เหตุขัดข้องแรกหลังเปลี่ยนมือจะไม่มีใครเห็น รับ runbook แผนผังระบบ รายการ integration และ cron job รวมถึง ticket ค้าง known issues และงานที่สัญญาไว้กับผู้ใช้
ตารางด้านล่างสรุปรายการรับมอบทั้งหมดทุกกลุ่ม พร้อมผู้รับผิดชอบฝั่งองค์กรและหลักฐานที่ควรได้:
| รายการรับมอบ | ผู้รับผิดชอบฝั่งองค์กร | หลักฐานที่ควรได้ |
|---|---|---|
| ซอร์สโค้ดและประวัติทั้งหมด | หัวหน้าทีมพัฒนาฝั่งใหม่ | mirror ของ repository อยู่ในบัญชีองค์กร พร้อม tag ที่ตรงกับ production |
| Pipeline และ configuration | ทีม DevOps / ผู้ดูแลระบบ | build และ deploy ขึ้น staging สำเร็จโดยทีมใหม่ |
| บัญชี Cloud และเซิร์ฟเวอร์ | IT Manager | root/owner ผูกอีเมลกลางขององค์กร เปิด MFA และมีรายชื่อผู้มีสิทธิ์ปัจจุบัน |
| โดเมน DNS และใบรับรอง TLS | IT Manager | ผู้ถือครองโดเมนเป็นองค์กร มีวันหมดอายุของโดเมนและใบรับรองในปฏิทินทีม |
| บริการภายนอกและ license | ฝ่ายจัดซื้อร่วมกับ IT | ทะเบียนบัญชี ผู้จ่ายเงิน และวันต่ออายุ |
| Credentials และ secrets | ผู้ดูแลความปลอดภัย | รายการ secrets ทั้งหมด และบันทึกการ rotate หลังรับมอบ |
| ฐานข้อมูลและ backup | ผู้ดูแลฐานข้อมูล | ผลกู้คืนลง staging พร้อมวันที่และผู้ทดสอบ |
| Monitoring และ alert | ทีมปฏิบัติการ | ผู้รับ alert เป็นทีมใหม่ และทดสอบส่ง alert แล้ว |
| เอกสารและ runbook | หัวหน้าทีมพัฒนาฝั่งใหม่ | ทีมใหม่ทำงานประจำตาม runbook ได้โดยไม่ต้องถาม |
| Ticket และ known issues | เจ้าของระบบฝั่งธุรกิจ | รายการงานค้างที่จัดลำดับและยืนยันร่วมกัน |
สัญญาจ้างเดิมต้องเช็กข้อไหนก่อนเปลี่ยนผู้รับจ้าง?
ให้เช็กสามเรื่องก่อน คือ ใครเป็นเจ้าของซอร์สโค้ดและทรัพย์สินทางปัญญา ผู้รับจ้างมีหน้าที่ช่วยส่งมอบเมื่อสัญญาสิ้นสุดหรือไม่ และต้องคืนหรือลบข้อมูลขององค์กรอย่างไร ถ้าสัญญาไม่ได้เขียนไว้ ควรเจรจาก่อนสัญญาหมดอายุ เพราะเป็นช่วงที่ยังมีข้อผูกพันต่อกัน
ตัวอย่างจากแนวปฏิบัติของรัฐบาลสหราชอาณาจักรช่วยให้เห็นว่าควรเขียนเรื่องอะไร (ไม่ใช่กฎหมายไทย และควรให้ที่ปรึกษากฎหมายตรวจกับสัญญาจริง):
- การคืนและลบข้อมูล: หลักการข้อ 6 ของ NCSC Supply chain security ระบุว่าสัญญาควรกำหนดข้อกำหนดที่ชัดเจนเรื่องการคืนและลบข้อมูลและทรัพย์สินขององค์กรเมื่อสัญญาสิ้นสุดหรือโอนไปยังผู้ให้บริการรายอื่น
- Exit management: คู่มือ Mid-Tier Contract ของ GOV.UK มี Schedule 30 ว่าด้วยสิ่งที่ผู้รับจ้างต้องทำเมื่อสัญญาสิ้นสุด เช่น จัดเก็บคลังเอกสาร (virtual library) จัดทำแผนออก (exit plan) และให้ความช่วยเหลือช่วงยุติสัญญา ครอบคลุมกรณีย้ายไปผู้รับจ้างรายใหม่หรือดึงกลับมาทำเอง
- ความเป็นเจ้าของทรัพย์สินทางปัญญา: แม่แบบเดียวกันมีทางเลือกเรื่อง IPR หลายแบบ เช่น ผู้ว่าจ้างเป็นเจ้าของ IPR ใหม่ทั้งหมด หรือผู้รับจ้างเป็นเจ้าของโดยผู้ว่าจ้างมีสิทธิ์ใช้เฉพาะในสัญญาปัจจุบัน และซอฟต์แวร์สำเร็จรูป (COTS) จัดการแยกจากงานที่พัฒนาใหม่ ให้ตรวจว่าสัญญาของเราอยู่แบบไหน เพราะกระทบโดยตรงต่อสิทธิ์ที่ทีมใหม่จะแก้โค้ดต่อ
หากกำลังเตรียมสัญญาดูแลระบบฉบับใหม่ให้ทีมที่มารับช่วง อ่านต่อได้ที่ เช็กลิสต์สัญญา MA และ SLA เพื่อใส่เงื่อนไขส่งมอบไว้ตั้งแต่วันแรก ไม่ต้องมาแก้ปัญหาเดิมในรอบถัดไป
ช่วงส่งต่องานและถ่ายทอดความรู้ (Knowledge Transfer) ควรทำอะไร และใช้เวลานานเท่าไร?
ช่วงถ่ายทอดความรู้ (Knowledge Transfer) ควรเป็นช่วงที่ทีมใหม่ "ลงมือทำ" โดยมีทีมเดิมคอยดู ไม่ใช่แค่ฟังบรรยาย เริ่มจากทีมใหม่สังเกตการทำงานของทีมเดิม (shadow) แล้วสลับเป็นทีมใหม่ทำเองโดยมีทีมเดิมกำกับ (reverse shadow) ก่อนรับผิดชอบเต็มตัว ส่วนระยะเวลาควรกำหนดจากเกณฑ์ผ่าน ไม่ใช่จำนวนวัน
- ให้ทีมใหม่ทำ release จริงอย่างน้อยหนึ่งครั้งระหว่างที่ทีมเดิมยังอยู่
- แปลง session ถาม-ตอบเป็น runbook ทันที ไม่เก็บเป็นวิดีโออย่างเดียว
- กำหนดว่าระหว่างช่วงนี้ เหตุขัดข้องบน production ใครเป็นผู้ตัดสินใจและใครลงมือ
ระยะเวลาขึ้นกับขนาดและความซับซ้อนของระบบ จึงควรกำหนดเป็นเกณฑ์ผ่าน (exit criteria) เช่น ทีมใหม่ทำ release เองได้ และทำงานประจำตาม runbook ได้โดยไม่ต้องถาม มากกว่ากำหนดเป็นจำนวนวัน
จะรู้ได้อย่างไรว่ารับมอบครบจริง?
ให้ทีมใหม่พิสูจน์ด้วยการลงมือทำสี่ขั้น คือ build จากซอร์สโค้ด deploy ขึ้น staging กู้คืนข้อมูลจาก backup และยืนยันว่าเข้าถึงทุกบัญชีด้วยสิทธิ์ขององค์กร ก่อนถอนสิทธิ์ทีมเดิม ถ้าขั้นใดต้องขอความช่วยเหลือจากทีมเดิม แปลว่ายังรับมอบไม่ครบ
- Rebuild: clone repository จากบัญชีองค์กร แล้ว build ตามเอกสาร ผลลัพธ์ควรตรงกับเวอร์ชันที่รันบน production ถ้าต้องใช้ไฟล์หรือค่าที่ไม่อยู่ใน repository ให้บันทึกเพิ่มในรายการรับมอบ
- Deploy: ใช้ pipeline ที่รับมอบมา deploy ขึ้น staging แล้วทดสอบการทำงานหลักของผู้ใช้
- Restore: กู้คืนฐานข้อมูลและไฟล์จาก backup จริงลง staging ตรวจจำนวนข้อมูลและการทำงานของระบบกับข้อมูลที่กู้มา ตามแนวคิดของ Google SRE ที่ว่าจะรู้ว่ากู้คืนได้ก็ต่อเมื่อได้ลองกู้จริง และควรทำให้การทดสอบนี้เป็นอัตโนมัติและทำต่อเนื่องเมื่อทำได้
- Access check แล้ว Revoke: ทีมใหม่ล็อกอินทุกบัญชีในรายการด้วยบัญชีขององค์กร และทดลองจัดการ DNS กับ alert ได้เอง เมื่อยืนยันแล้วจึงถอนสิทธิ์ทีมเดิมและเปลี่ยน secrets ตามหัวข้อถัดไป
หาก staging หรือ pipeline เดิมไม่สมบูรณ์ ให้รวมงาน DevOps & SRE และ Cloud ไว้ในแผนรับช่วงตั้งแต่ต้น
หลังรับมอบ ต้องปิดความเสี่ยงด้านความปลอดภัยอะไรบ้าง?
ต้องถอนสิทธิ์ทุกอย่างของผู้ดูแลเดิมที่ไม่จำเป็นแล้ว และเปลี่ยน (rotate) รหัสผ่าน API key และ secrets ที่ทีมเดิมเคยรู้ การลบบัญชีผู้ใช้อย่างเดียวไม่พอ เพราะ secrets ที่ถูกคัดลอกไปแล้วยังใช้งานได้จนกว่าจะเปลี่ยน
- ถอนสิทธิ์: แนวทาง NCSC Supply chain security (หลักการข้อ 5 กรณีเชื่อมระบบของผู้ให้บริการเข้ากับระบบขององค์กร) ระบุว่าสิทธิ์เข้าถึงควรจำกัด ควบคุม และเฝ้าดู ทบทวนเป็นระยะ และถอนออกเมื่อไม่จำเป็น สำหรับการเปลี่ยนผู้รับจ้าง ให้ไล่ทั้งบัญชีผู้ใช้ SSH key, VPN, repository, CI/CD, Cloud console, DNS และบริการภายนอก
- Revoke และ rotate secrets: OWASP Secrets Management Cheat Sheet ระบุว่า secrets ที่ไม่จำเป็นหรืออาจรั่วต้อง revoke และควร rotate เป็นประจำ เพื่อให้ credentials ที่ถูกขโมยใช้ได้ในเวลาสั้นๆ
- ระวัง secrets ในโค้ด: OWASP ระบุว่าหลายองค์กรมี secrets ฝังเป็น plaintext ในซอร์สโค้ดและไฟล์ configuration และแม้จะเขียนประวัติ git ใหม่ได้ แต่วิธีนั้นทำให้ลิงก์ไปยัง commit เดิมเสีย และแนะนำให้ใช้ระบบจัดการ secrets โดยเฉพาะ ในทางปฏิบัติจึงควรถือว่า secret ที่เคยอยู่ในโค้ดรั่วแล้ว ให้ rotate และย้ายไปเก็บในระบบจัดการ secrets
- จำกัดและเฝ้าดูสิทธิ์: ให้ทีมใหม่ได้สิทธิ์เท่าที่ต้องใช้ และตั้ง alert เมื่อมีการใช้บัญชีระดับสูงสุด ตามที่คู่มือ AWS แนะนำสำหรับ root user
แผนรับช่วงระบบแบบเป็นเฟสควรมีขั้นอะไรบ้าง?
แบ่งเป็นห้าเฟส คือ สำรวจและทำรายการรับมอบ, ส่งต่องานแบบ shadow, ตรวจด้วยการลงมือทำ, สลับผู้รับผิดชอบ และถอนสิทธิ์ทีมเดิม แต่ละเฟสควรมีเกณฑ์ผ่านก่อนไปเฟสถัดไป ไม่ใช่ผ่านเพราะครบกำหนดวัน
- Inventory: ทำรายการรับมอบตามตารางรับมอบระบบด้านบน ระบุผู้รับผิดชอบ และขอสิทธิ์อ่านทุกบัญชีโดยเร็ว
- Shadow / Knowledge Transfer: ทีมใหม่สังเกตแล้วสลับเป็นผู้ลงมือ โดยทีมเดิมยังรับผิดชอบ production
- Verify: rebuild, deploy ขึ้น staging และ restore test ผ่านโดยทีมใหม่
- Cutover: ย้ายผู้รับ alert, on-call และความรับผิดชอบ production มาที่ทีมใหม่ โดยทีมเดิมยังตอบคำถามได้ตามที่ตกลง
- Revoke & rotate: ถอนสิทธิ์ทีมเดิม rotate secrets ยืนยันการคืนหรือลบข้อมูลตามสัญญา และปิดรายการรับมอบ
ตัวอย่างสมมติ: รับช่วงระบบสั่งซื้อภายใน
ตัวเลขและเหตุการณ์ต่อไปนี้เป็นตัวอย่างสมมติเพื่ออธิบายวิธีคิด ไม่ใช่ผลลัพธ์จากลูกค้า และไม่ใช่ระยะเวลาที่รับประกัน สมมติองค์กรมีระบบสั่งซื้อภายในหนึ่งระบบ สัญญาดูแลกับผู้รับจ้างเดิมเหลือ 8 สัปดาห์ ทีมวางแผนดังนี้
- สัปดาห์ 1–2 (Inventory): พบว่าโดเมนจดในชื่อผู้รับจ้าง และบัญชีส่งอีเมลผูกกับอีเมลส่วนตัวของนักพัฒนา จึงเริ่มโอนก่อนรายการอื่น
- สัปดาห์ 3–4 (Shadow): ทีมใหม่ทำ release หนึ่งครั้งโดยมีทีมเดิมกำกับ และพบ configuration ที่ตั้งด้วยมือบนเซิร์ฟเวอร์ จึงบันทึกเข้า repository
- สัปดาห์ 5 (Verify): restore test ครั้งแรกล้มเหลว เพราะ backup ไม่รวมโฟลเดอร์ไฟล์แนบ ทีมเดิมแก้ตาราง backup แล้วทดสอบซ้ำจนผ่าน
- สัปดาห์ 6–7 (Cutover): ย้าย alert และ on-call มาที่ทีมใหม่
- สัปดาห์ 8 (Revoke): ถอนสิทธิ์ทีมเดิม rotate secrets ทั้งหมด และรับหนังสือยืนยันการลบข้อมูลตามสัญญา
ประเด็นคือ restore test ที่ล้มเหลวระหว่างที่ทีมเดิมยังอยู่ ดีกว่าค้นพบตอนเกิดเหตุจริงหลังทีมเดิมออกไปแล้ว
ก่อนปิดการรับมอบ ต้องเช็กอะไรให้ครบ?
ปิดการรับมอบได้เมื่อทุกข้อด้านล่างมีหลักฐาน และทีมใหม่ทำได้เองโดยไม่พึ่งทีมเดิม ถ้าข้อใดยังต้องถามทีมเดิม ให้เก็บเป็นงานค้างก่อนถอนสิทธิ์
- Repository ทั้งชุดพร้อมประวัติอยู่ในบัญชีขององค์กร และรู้ว่า commit ไหนรันบน production
- ทีมใหม่ build และ deploy ขึ้น staging ได้เองผ่าน pipeline
- Restore test จาก backup จริงผ่าน มีวันที่และผู้ทดสอบ
- บัญชี Cloud โดเมน DNS และบริการภายนอกอยู่ในชื่อองค์กร ผูกอีเมลกลาง และเปิด MFA
- Alert ส่งถึงทีมใหม่ และมี runbook สำหรับงานประจำ
- ตรวจข้อสัญญาเรื่อง IP การส่งมอบ และการคืนหรือลบข้อมูล ร่วมกับที่ปรึกษากฎหมาย
- ถอนสิทธิ์ทีมเดิมและ rotate secrets ครบ พร้อมบันทึก
เมื่อควบคุมระบบได้แล้ว ขั้นถัดไปคือเลือกว่าจะให้ใครดูแลต่อ ดู Managed Services หรือทีม IT ภายใน และ วิธีเลือกบริษัทพัฒนาซอฟต์แวร์ หากต้องเตรียมขอบเขตงานเพื่อขอใบเสนอราคาจากผู้รับจ้างรายใหม่ อ่าน เช็กลิสต์เตรียมขอใบเสนอราคาพัฒนาซอฟต์แวร์
UNIXDEV รับช่วงดูแลระบบที่ใช้งานอยู่ผ่านบริการ Legacy Application Maintenance โดยเริ่มจากสำรวจรายการรับมอบ ตรวจด้วยการ build, deploy และ restore บน staging แล้วจึงรับผิดชอบงานดูแลต่อ เพื่อให้องค์กรควบคุมระบบของตัวเองได้ก่อนวางแผนปรับปรุง
แหล่งอ้างอิงและอ่านต่อ
- NCSC — Supply chain security guidance, II. Establish control
- GOV.UK — The Mid-Tier Contract: guidance for buyers
- GOV.UK Service Manual — Making source code open and reusable
- Google SRE Book — Data Integrity
- OWASP — Secrets Management Cheat Sheet
- AWS — Root user best practices
- ICANN — Transfer Policy (2024)
- Git — git-clone
- NIST SP 800-34 Rev. 1 — Contingency Planning Guide for Federal Information Systems
- บทความที่เกี่ยวข้อง: แนวทางปรับปรุงระบบเก่า
บทความโดย UNIXDEV Team · 23 ตุลาคม 2026 · สรุปแนวปฏิบัติเพื่อประกอบการวางแผน ไม่ใช่คำแนะนำทางกฎหมาย และตัวอย่างแผนเป็นสถานการณ์สมมติ
คำถามที่พบบ่อย
เปลี่ยนผู้รับจ้างดูแลระบบ ต้องรับมอบอะไรจากผู้รับจ้างเดิมบ้าง?
ต้องรับมอบทุกอย่างที่จำเป็นต่อการ build, deploy, เปิดให้บริการ และกู้คืนระบบโดยไม่ต้องพึ่งทีมเดิม ได้แก่ ซอร์สโค้ดพร้อมประวัติและ pipeline, บัญชี Cloud โดเมน DNS ใบรับรอง TLS และบริการภายนอก, ฐานข้อมูลกับ backup และผลทดสอบกู้คืน, monitoring กับ runbook และรายการงานค้าง
ได้ซอร์สโค้ดเป็นไฟล์ zip จากผู้รับจ้างเดิมพอไหม?
ไม่พอ เพราะไฟล์ zip ไม่มีประวัติการแก้ไข และอาจไม่รู้ว่าเวอร์ชันไหนรันอยู่บน production ควรรับ repository ทั้งชุด เช่น mirror ที่ได้จาก git clone --mirror เก็บไว้ในบัญชีขององค์กร พร้อมระบุ commit ที่ตรงกับ production
จะรู้ได้อย่างไรว่ารับมอบระบบครบแล้ว?
ให้ทีมใหม่ build ระบบจากซอร์สโค้ด deploy ขึ้น staging กู้คืนข้อมูลจาก backup จริง และเข้าถึงทุกบัญชีด้วยสิทธิ์ขององค์กรได้เอง หากขั้นใดต้องขอความช่วยเหลือจากทีมเดิม แปลว่ายังรับมอบไม่ครบ
สัญญาจ้างเดิมควรเช็กข้อไหนก่อนเปลี่ยนผู้รับจ้างดูแลระบบ?
เช็กว่าใครเป็นเจ้าของซอร์สโค้ดและทรัพย์สินทางปัญญา ผู้รับจ้างมีหน้าที่ช่วยส่งมอบเมื่อสัญญาสิ้นสุดหรือไม่ และต้องคืนหรือลบข้อมูลขององค์กรอย่างไร ควรให้ที่ปรึกษากฎหมายตรวจกับสัญญาจริง และเจรจาก่อนสัญญาหมดอายุ
หลังรับมอบระบบแล้ว ต้องทำอะไรด้านความปลอดภัย?
ถอนสิทธิ์ทุกอย่างของผู้ดูแลเดิมที่ไม่จำเป็นแล้ว ทั้งบัญชีผู้ใช้ SSH key, VPN, repository, CI/CD, Cloud, DNS และบริการภายนอก จากนั้น rotate รหัสผ่าน API key และ secrets ที่ทีมเดิมเคยรู้ เพราะ secrets ที่ถูกคัดลอกไปแล้วยังใช้ได้จนกว่าจะเปลี่ยน
ควรวางแผนรับช่วงระบบจากผู้รับจ้างเดิมอย่างไร?
แบ่งเป็นห้าเฟส คือ สำรวจและทำรายการรับมอบ ส่งต่องานแบบ shadow ตรวจด้วยการ rebuild, deploy และ restore สลับผู้รับผิดชอบ production และถอนสิทธิ์ทีมเดิมพร้อม rotate secrets โดยแต่ละเฟสควรผ่านเกณฑ์ก่อนไปเฟสถัดไป ไม่ใช่ผ่านเพราะครบกำหนดวัน