▲ UnixDev Engineering Blog / บทความตามหัวข้อ

บทความเรื่อง DevOps และดูแลระบบองค์กร

บทความเกี่ยวกับ DevOps, SRE และการดูแลระบบ production ครอบคลุมสัญญา MA และ SLA การเลือกระหว่าง managed services กับทีมภายใน และการวัดประสิทธิภาพของ Linux, HAProxy และเว็บไซต์ก่อนปรับจูน เหมาะกับทีม IT และผู้ดูแลระบบที่ต้องรักษาระบบให้ทำงานต่อเนื่อง

บทความในหัวข้อนี้ (7)

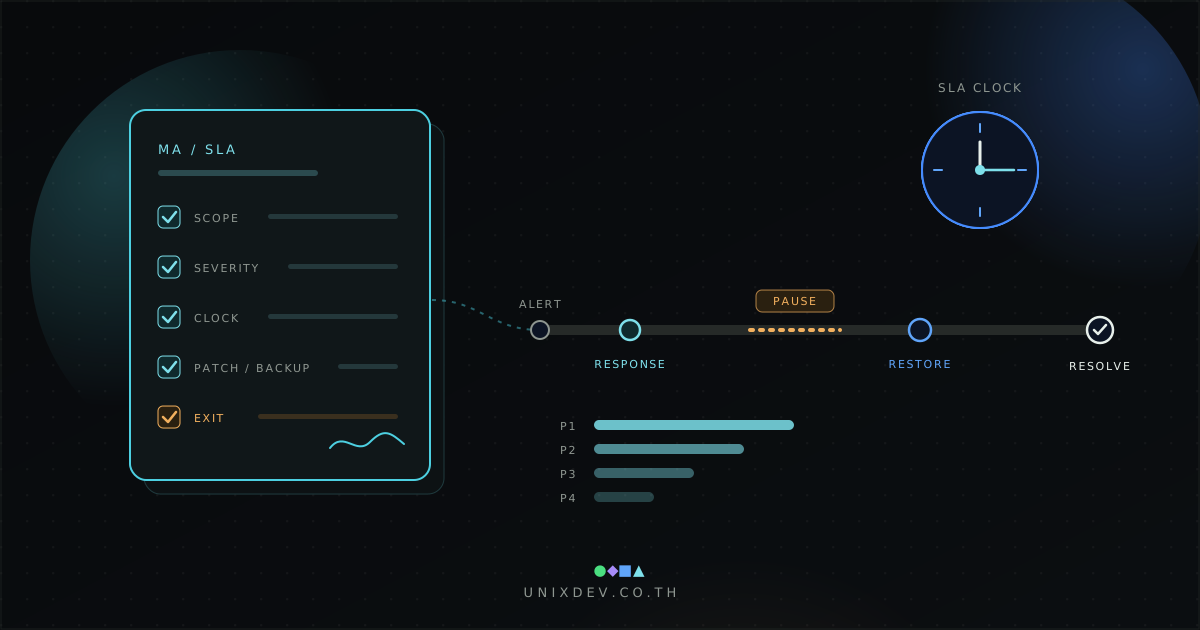
เอกสารสัญญาดูแลระบบที่มีรายการข้อสัญญาถูกตรวจทีละข้อ เชื่อมกับเส้นเวลาของเหตุขัดข้องที่แยกจุดรับเรื่อง จุดที่ระบบกลับมาใช้ได้ และจุดแก้ไขถาวร พร้อมช่วงที่นาฬิกา SLA หยุดพัก
MA / SLA •

สัญญา MA และ SLA ดูแลระบบ: ขอบเขตที่ต้องตรวจก่อนเซ็น

ก่อนเซ็นสัญญา MA และ SLA ดูแลระบบ ให้ตรวจว่างานใดรวมในค่า MA งานใดเป็น Change Request ระดับความรุนแรงนิยามอย่างไร SLA แยก response, restoration และ resolution หรือไม่ นาฬิกา SLA เริ่ม พัก หยุดเมื่อไร และใครรับผิดชอบ patch, backup และ dependency
ไดอะแกรมเปรียบเทียบ DevOps กับ SRE แสดง delivery pipeline ฝั่ง DevOps และ reliability loop ที่มี SLO และ error budget ฝั่ง SRE พร้อม feedback loop เชื่อมสองฝั่งเข้าด้วยกัน
SRE vs DevOps • •อัปเดต

SRE vs DevOps: เส้นแบ่งที่ทีม IT องค์กรไทยยังสับสนอยู่

SRE (Site Reliability Engineering) คือการดูแลความเสถียรของระบบด้วยวิธีวิศวกรรม ดูความต่างจาก DevOps พร้อมตาราง SLI, SLO และ Error Budget

ไปป์ไลน์ DevOps อัตโนมัติ จาก commit ผ่าน build, test, deploy ไปสู่ monitor พร้อมแสดงต้นทุนแฝงที่รั่วไหลจากการ deploy แบบ manual
DevOps • •อัปเดต

DevOps คืออะไร และทำไมองค์กรไทยที่ไม่มี DevOps ถึงเสีย Budget ทิ้งโดยไม่รู้ตัว

DevOps ย่อมาจาก Development + Operations คือแนวทางที่ทีมพัฒนาและทีมดูแลระบบทำงานร่วมกัน ดูหลักการ CI/CD เครื่องมือ และต้นทุนแฝงเมื่อยังไม่มี DevOps

ทีม IT ในองค์กรเปรียบเทียบกับ dashboard Managed Services บนหน้าจอ
Managed Services • •อัปเดต

Managed Services vs In-house IT: คุ้มไหมสำหรับองค์กรไทยในปี 2026

เปรียบเทียบ Managed Services กับการดูแล IT ในองค์กรแบบ In-house แบบตรงไปตรงมา พร้อมวิธีเทียบ TCO บนเงื่อนไขเดียวกัน (ตัวเลขในบทความเป็นตัวอย่างสมมติ) และเช็กลิสต์ว่าองค์กรคุณเหมาะกับแบบไหน

Virtualized data center infrastructure used as the article cover image
Systems Care • •อัปเดต

เว็บไซต์ช้า: ตรวจหาสาเหตุให้ชัดก่อนตัดสินใจขยาย server

แนวทางตรวจหาสาเหตุของระบบช้าทีละชั้น ตั้งแต่ code, web server, database, OS, storage ไปจนถึง network และ monitoring พร้อมวิธีเปลี่ยนค่าอย่างมีการควบคุมและวัดผลเทียบกับ baseline

Linux performance tuning slide cover image
Linux Performance • •อัปเดต

เครื่องมือ Linux Performance: วัดให้ถูกก่อนปรับจูนระบบ

แนวทางเลือกเครื่องมือวัด CPU, memory, storage และ network บน Linux เพื่อหาคอขวดจากหลักฐาน พร้อมข้อควรระวังในการอ่านค่าและเช็กลิสต์ก่อนปรับจูนระบบ

HAProxy performance tuning article cover image
Load Balancing • •อัปเดต

HAProxy สำหรับฐานข้อมูล: ควรตรวจอะไรก่อนปรับจูนประสิทธิภาพ

แนวทางตรวจ health check, พฤติกรรมของ connection, การวัดผล และการซ้อม failover ก่อนใช้ HAProxy กระจาย traffic ไปยังฐานข้อมูล