
ป้องกัน Ransomware บน Hypervisor และ Linux Server
Hardening ESXi, Proxmox VE และ Linux server กัน ransomware: แยก management network, MFA และ role, lockdown, สิทธิ์ backup ใน PBS และ log ของ host
บทความเกี่ยวกับ backup และการกู้คืนระบบในงานจริง ตั้งแต่ออกแบบ backup ให้รอดจาก ransomware ด้วย immutable หรือ offline copy การวาง backup ใน Proxmox VE การเก็บไฟล์บน Huawei Cloud OBS การเตรียม backup ก่อนอัปเกรดหรือรับช่วงระบบเดิม ไปจนถึงข้อที่ควรเขียนเรื่อง backup และการทดสอบ restore ในสัญญา MA และ TOR เหมาะกับทีม IT และผู้รับผิดชอบระบบที่ต้องการให้กู้คืนได้จริงเมื่อเกิดเหตุ
ดูบริการดูแลระบบที่รวม backup และการทดสอบ restore → บทความทั้งหมด →
บทความในหัวข้อนี้ (12)
Hardening ESXi, Proxmox VE และ Linux server กัน ransomware: แยก management network, MFA และ role, lockdown, สิทธิ์ backup ใน PBS และ log ของ host
วาง Proxmox VE cluster สำหรับ production: จำนวน node, quorum และ QDevice, HA ที่ fence ด้วย watchdog, Ceph หรือ ZFS replication, backup และเช็กลิสต์ก่อนใช้งาน
obsutil คือ CLI ของ Huawei Cloud OBS: ดาวน์โหลด ตั้งค่า endpoint AP-Bangkok ด้วย IAM user สิทธิ์จำกัด ใช้ cp, sync, -recover และวางแผนย้ายไฟล์จำนวนมากขึ้น OBS
Backup ที่ ransomware ลบไม่ได้ต่างจาก backup ทั่วไปอย่างไร เทียบ offline, air gap และ immutable อย่าง Object Lock พร้อมวิธีแยกสิทธิ์และทดสอบ restore
Ransomware คือมัลแวร์เข้ารหัสข้อมูลเพื่อเรียกค่าไถ่ วิธีป้องกัน การเก็บ backup ให้ผู้โจมตีเข้าไม่ถึง สิ่งที่ทำในชั่วโมงแรก และหน้าที่แจ้งเหตุตามกฎหมายไทย
TOR ย้ายระบบขึ้นคลาวด์ของหน่วยงานรัฐควรระบุอะไร: รายการระบบ ปลายทาง ชั้นข้อมูล มาตรฐาน สกมช. แผน cutover และ rollback หลักฐานตรวจรับรายงวด และข้อออกจากระบบ
Zimbra 8.8.15, 9.0 และ 10.0 ไม่ได้แพตช์แล้ว รุ่นที่ยังซัพพอร์ตคือ 10.1 เช็กลิสต์ก่อนอัปเกรด: license key ใหม่ โมดูล NG ระบบปฏิบัติการ backup และ rollback
ถ้าระบบเก่ายังย้ายไม่ได้ ให้ตรวจว่าส่วนไหนหมด support แล้ว แยกระบบไว้ในโซนเครือข่ายแยก ตัดเส้นทางข้อมูลที่ไม่จำเป็น เฝ้าระวังเชิงรุก ทำ backup ที่ทดสอบกู้คืนแล้ว และกำหนดเกณฑ์ว่าเมื่อไรต้องเร่ง modernize เพราะมาตรการชดเชยลดความเสี่ยงได้แต่ไม่ได้ปิดช่องโหว่
เริ่มจากปกป้องของที่มีอยู่: backup เต็มรูปแบบพร้อมทดสอบกู้คืน และเก็บสถานะเซิร์ฟเวอร์ก่อนแตะระบบ จากนั้นสร้างรายการระบบจากสิ่งที่รันอยู่ ทำ SBOM สังเกต log เขียน characterization test และเขียนเอกสารไปพร้อมกัน ก่อนตัดสินใจว่าจะดูแลต่อหรือปรับปรุง
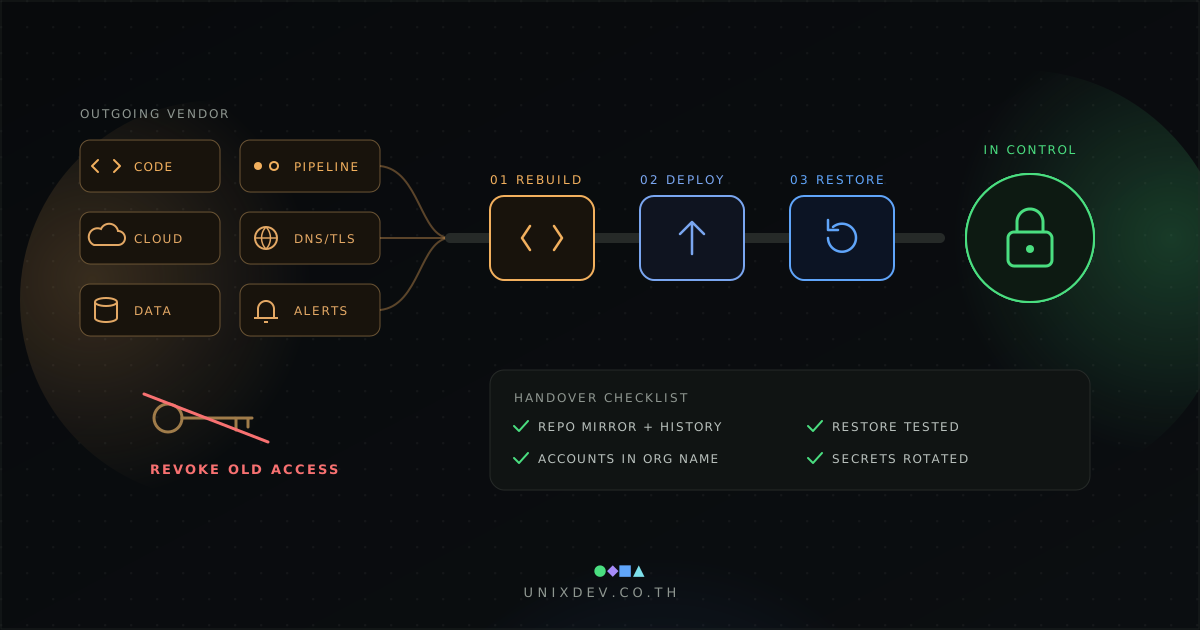
เมื่อเปลี่ยนผู้รับจ้างดูแลระบบ ต้องรับมอบซอร์สโค้ดพร้อมประวัติ pipeline บัญชี Cloud โดเมน backup และ runbook ให้อยู่ในชื่อองค์กร แล้วพิสูจน์ว่าครบด้วยการให้ทีมใหม่ build, deploy ขึ้น staging และ restore ได้เอง ก่อนถอนสิทธิ์ทีมเดิม
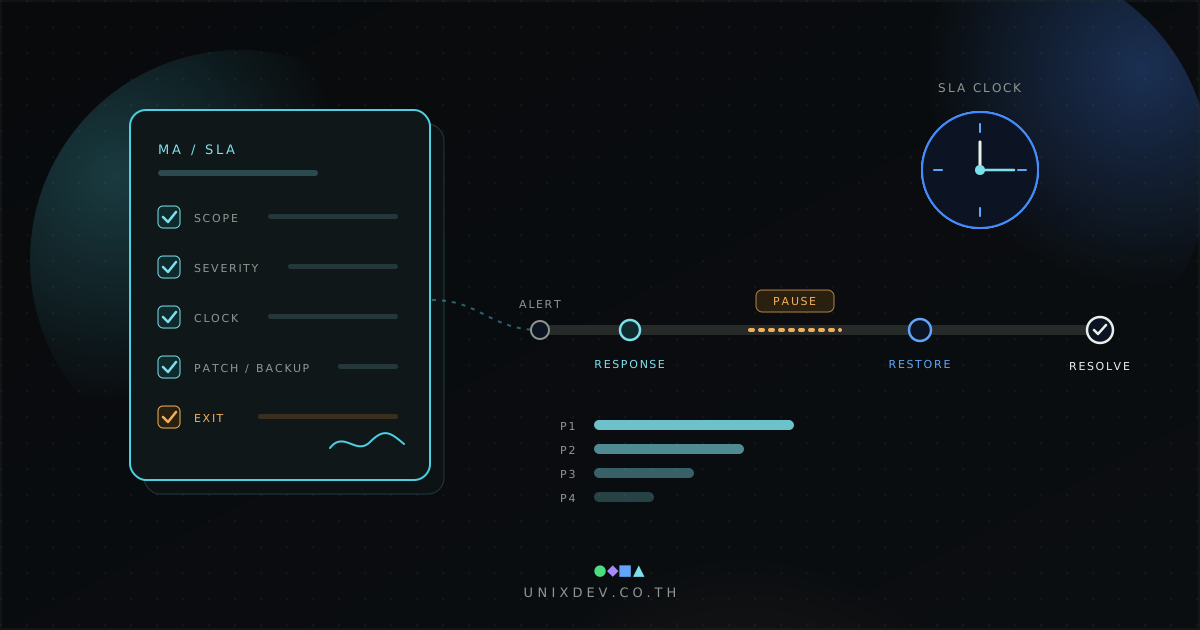
ก่อนเซ็นสัญญา MA และ SLA ดูแลระบบ ให้ตรวจว่างานใดรวมในค่า MA งานใดเป็น Change Request ระดับความรุนแรงนิยามอย่างไร SLA แยก response, restoration และ resolution หรือไม่ นาฬิกา SLA เริ่ม พัก หยุดเมื่อไร และใครรับผิดชอบ patch, backup และ dependency
แนวทางกำหนดขอบเขตการดูแลเว็บไซต์บริษัทหรือร้านค้าออนไลน์ที่ใช้งานอยู่ ตั้งแต่สำรวจระบบและสิทธิ์เข้าถึง อัปเดตผ่าน staging ลดความเสี่ยงด้านความปลอดภัย วัดผลก่อนปรับความเร็ว ไปจนถึงทดสอบการกู้คืนและตกลงขอบเขตบริการ
เลือกประเภทคุกกี้ที่คุณยินยอมให้เราใช้งาน · Choose which cookies you allow. อ่านรายละเอียด · Learn more